Questions fréquemment posées
DevOps
Que signifie le terme DevOps ?
Le terme « DevOps » est un acronyme pour « Development » et « Operations ».
DevOps ou DevSecOps est une approche, un état d’esprit ou une pratique qui vise à améliorer la collaboration entre les équipes de développement et d’exploitation pour opérer un projet logiciel.
Ce terme reflète la philosophie de cette méthodologie, qui vise à rapprocher ces deux métiers, souvent perçus comme antagonistes, afin de favoriser une meilleure collaboration et une plus grande efficacité.
Quelle est la différence entre DevOps et DevSecOps ?
Les deux termes sont très proches. DevOps ou DevSecOps est une approche, intégrant une culture, des pratiques et des outils, qui consiste à améliorer la communication et la collaboration entre les développeurs (Dev), l’assurance qualité (QA), la sécurité (Sec), les opérations (Ops) et tout autre service impliqué dans la livraison logicielle, afin d’aider les entreprises et organisations de toutes tailles et de tous secteurs d’activité (banque, finance, industrie, administrations publiques, associations, …) à déployer de nouveaux logiciels plus rapidement, plus efficacement et de manière plus sécurisée.
Comment fonctionne l’approche DevOps/DevSecOps ?
Inspirée des approches de développement Agile, l’approche DevOps / DevSecOps met l’accent sur une collaboration renforcée entre les développeurs et les équipes d’exploitation (administrateurs systèmes, opérations, …) afin d’optimiser la livraison du code, les tests et l’infrastructure de production.
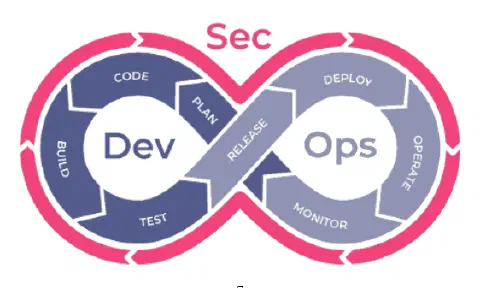
Pour plus d’agilité, développeurs et opérateurs travaillent sur des mises à jour logicielles et d’infrastructure de petite taille, livrées indépendamment les unes des autres. Pour déployer du code applicatif structuré en microservices, les équipes DevOps utilisent l’intégration continue (CI), la livraison continue (CD) et des technologies de conteneurs comme Docker, Kubernetes, OpenShift, etc. (sur site ou dans le cloud), essentielles pour garantir la cohérence des environnements de déploiement et d’hébergement, mais aussi pour optimiser la gestion de la sécurité, de la scalabilité et de la résilience des applications. L’observabilité joue également un rôle très important, via les logs, les métriques et le tracing, pour avoir toujours une vue complète du système. Enfin, les problèmes identifiés en production alimentent des améliorations du code, dans une boucle de rétroaction continue.
C’est ce qu’on appelle la boucle de rétroaction DevOps, ou boucle infinie DevOps :
Qu’est-ce qu’une équipe DevOps / DevSecOps ?
Une équipe DevOps / DevSecOps est composée de collaborateurs issus du Développement (chef de projet, développeur, …), de la Sécurité, du Déploiement (ingénieur IT, administrateurs systèmes, …) et de toute autre équipe impliquée dans le cycle de vie logiciel, qui travaillent ensemble pour améliorer la communication et la collaboration entre les deux disciplines. L’objectif est de permettre aux équipes de développement et de déploiement de mieux travailler ensemble afin d’accélérer le cycle de développement et de déploiement des applications logicielles, tout en le rendant plus fiable !
Qu’est-ce qu’un ingénieur DevOps / DevSecOps ?
Un ingénieur DevOps doit comprendre la philosophie DevOps / DevSecOps mais aussi les outils et logiciels qui la composent. Cela implique donc de comprendre les perspectives de développement, de sécurité, de production et d’exploitabilité.
Il doit disposer d’une expertise en automatisation, Infra-as-Code, intégration continue, déploiement, orchestration de conteneurs, sécurité, observabilité, …. Il travaille en collaboration avec les différentes équipes de développement et d’infrastructure pour améliorer les processus de développement et de livraison applicative tout en garantissant la stabilité et la sécurité.
Quel est le cycle de vie d’une approche DevOps / DevSecOps ?
Visant à améliorer la productivité du cycle de vie de développement d’une application logicielle, l’approche DevOps / DevSecOps peut être imaginée comme une boucle infinie, composée de 8 étapes qui se répètent
Planification : Dans un premier temps, l’équipe identifie les besoins et attentes des utilisateurs finaux (clients, direction ou utilisateurs internes) et travaille à la rédaction d’un cahier des charges et d’un planning de développement associé afin d’identifier le MVP (Minimum Viable Product), c’est-à-dire la version d’un logiciel qui permet d’obtenir un maximum de retours avec un minimum d’effort, puis de constituer un backlog selon les méthodes agiles
Création du code : À cette étape, les équipes procèdent au développement effectif de l’application en suivant des itérations Agile par Sprint.
Construction (Build) : Une fois les tâches de développement terminées, le code est déposé dans un dépôt partagé (Git Repository) et l’on procède alors à une phase d’intégration continue (CI) permettant de compiler le code source, de valider la qualité du code, de packager l’application, d’exécuter les différents niveaux de tests (tests unitaires, tests d’intégration, tests système, … ), de construire l’image Docker, de valider les bonnes pratiques, de s’assurer de l’absence de vulnérabilités critiques dans l’image et de déployer l’image dans un gestionnaire d’artefacts.
Versioning : Le versioning peut être réalisé de plusieurs manières et peut être automatisé via une approche d’auto-versioning. Une fois la phase de test terminée et réussie, le Build est préparé par les ingénieurs DevOps pour être déployé dans l’environnement de production.
Test : Il est possible de prévoir une phase de test permettant de valider le comportement de l’application dans un environnement d’intégration (aussi proche que possible de la Production) où sont alors réalisés des tests d’intégration, de l’automatisation d’interface utilisateur, ainsi que des tests manuels, tels que des tests de recette utilisateur.
Déploiement : À cette étape, le build est déployé, testé et mis en œuvre en production pour être disponible aux utilisateurs finaux.
Exploitation (Operation) : Les équipes infrastructure IT orchestrent les étapes de conception, de mise en œuvre, de configuration, de déploiement et de maintenance pour garantir la disponibilité continue de l’application logicielle développée.
Supervision (Monitoring) : Les équipes DevOps surveillent chaque mise en production et rédigent des recommandations techniques et fonctionnelles pour améliorer les futures livraisons logicielles.
Pour accélérer le temps de mise en production des applications et garantir la conformité des versions, les équipes IT utilisent des pipelines CI/CD et d’autres formes d’automatisation pour faire progresser le code d’une étape de développement et de déploiement à l’autre.
Pourquoi faire du DevOps : les bénéfices de l’approche ?
La mise en place d’une approche DevOps permet d’améliorer plusieurs points fondamentaux. Voici les principaux bénéfices que vous pouvez en tirer.
Une livraison logicielle plus rapide Avec un pipeline CI/CD, les déploiements sont plus rapides et plus fréquents. Il faut moins de temps pour mettre à jour les services existants et déployer de nouveaux systèmes, fonctionnalités ou correctifs. Cela peut aussi offrir un avantage concurrentiel significatif et une meilleure expérience utilisateur.
Une collaboration améliorée Avec les pratiques DevOps, les équipes de développement et d’exploitation travaillent en étroite collaboration, avec des responsabilités partagées, ce qui augmente la visibilité sur le travail réalisé. Plus connectées, les équipes travaillent toutes vers les mêmes objectifs.
Une meilleure productivité Grâce à une communication améliorée, aux bons outils et à un processus de développement priorisé, les équipes travaillent plus efficacement.
Automatisation des tâches répétitives L’automatisation des tâches répétitives est l’un des aspects les plus importants du DevOps, permettant aux équipes de développement et d’exploitation de se concentrer sur des tâches à plus forte valeur ajoutée et de réduire les erreurs humaines.
Une qualité et une fiabilité accrues Les pratiques d’intégration et de livraison continues garantissent que les changements sont fonctionnels et stables, ce qui améliore la qualité d’un produit logiciel. Le monitoring permet également aux équipes de suivre les performances en temps réel.
Une meilleure sécurité En adoptant une approche « Security as Code » dès le début du cycle de développement, il est plus facile d’identifier et de corriger les vulnérabilités potentielles avant que le logiciel ne soit mis en production.
Des mises en production plus fréquentes Les clients peuvent recevoir des mises à jour et des correctifs plus fréquemment, ce qui se traduit également par une meilleure satisfaction client.
Quels outils choisir pour mettre en place une approche DevOps ?
Les outils DevOps facilitent et automatisent les tâches répétitives du cycle de développement logiciel. Ils aident également les équipes à collaborer efficacement et à suivre les modifications du code au fil du temps.
Parmi les outils les plus populaires, on retrouve Puppet, Kubernetes, Docker, Chef, Ansible, SaltStack et Jenkins.
Qu’est-ce qu’Azure DevOps ?
Azure DevOps est une plateforme de collaboration en ligne qui permet aux équipes de développement de gérer l’ensemble du cycle de vie de développement d’un projet, du codage à la livraison. Azure DevOps propose un large éventail de services pour accompagner les équipes de développement et leur permettre de livrer leurs projets de manière fiable et sécurisée.
Quels sont les défis liés à la mise en place d’une approche DevOps ?
La mise en place d’une approche DevOps peut être complexe et exigeante pour les entreprises. En effet, il est nécessaire de prendre en compte plusieurs facteurs tels que la culture d’entreprise, les processus existants, les outils utilisés, etc. La formation des collaborateurs est l’un des points de vigilance à prendre en compte pour limiter une éventuelle carence des membres d’une équipe concernant la méthodologie de gestion de projet ou la maîtrise des outils utilisés.
À cet effet, une formation DevOps permet d’acquérir les compétences nécessaires pour mettre en place une approche DevOps dans votre entreprise.
Approche Agile
Qu’est-ce qu’un framework Agile ?
Un framework Agile se traduit par un état d’esprit (valeurs et principes) et des pratiques. L’ensemble soutient l’efficience de la création de valeur ainsi que l’efficacité opérationnelle. En plaçant l’utilisateur final au centre des préoccupations de l’équipe de développement, en garantissant une approche empirique soutenant un principe d’amélioration continue, le framework Agile donne du sens à l’action collective des collaborateurs.
Quelles sont les caractéristiques d’un framework Agile ?
- Leadership et dynamique collaborative
- Vision produit et hypothèses de création de valeur
- Développement itératif et incrémental
- Amélioration continue, apprentissage et retours utilisateurs
Qu’est-ce que le Manifeste Agile ?
Rédigé par un groupe de développeurs en 2001, le Manifeste Agile vise à moderniser, fiabiliser et accélérer les processus de développement d’applications logicielles à travers la mise en œuvre de 12 principes de développement, fondés sur 4 valeurs.
Le Manifeste Agile, lorsqu’il s’incarne dans un processus de développement logiciel, traduit l’état d’esprit qui donne du sens aux principes Agile fondamentaux de collaboration, de communication, d’auto-organisation et de l’ambition de toujours mieux satisfaire les attentes des utilisateurs et clients finaux grâce à la livraison rapide et régulière de fonctionnalités applicatives.
Pour en savoir plus :
Quelles sont les 4 valeurs du Manifeste Agile ?
- Les individus et leurs interactions plus que les processus et les outils
- Un logiciel opérationnel plus qu’une documentation exhaustive
- La collaboration avec les clients plus que la négociation contractuelle
- L’adaptation au changement plus que le suivi d’un plan
Quels sont les principaux défis lors de la mise en place d’un framework Agile ?
- Pourquoi : Établir la raison du changement
- Pour quoi : Changer la culture, et pas seulement adopter des pratiques
- Qui : Engager toutes les parties prenantes impliquées dans la transformation
- Quoi : S’assurer que le travail quotidien est simplifié et porteur de sens
- Comment : Identifier et mettre en place des équipes Produit durables, autonomes et multidisciplinaires
Quand faut-il mettre en place un framework Agile dans son organisation ?
Dans un contexte « VUCA » ou un contexte complexe du point de vue de la matrice de Stacey, les approches empiriques sont plus efficaces. En effet, dans un contexte où tout problème rencontré peut trouver son origine dans de multiples causes, il est préférable d’avancer pas à pas et de confronter à la réalité ce que l’on pense être la meilleure solution. La décision ne peut être prise qu’après expérimentation et acquisition de connaissances.
Comment démarrer une démarche Agile ?
Dans un premier temps, il faut clairement définir pourquoi l’on souhaite changer. Faire évoluer une organisation vers une approche Agile n’est pas un objectif en soi. Il faut donc s’accorder sur l’objectif de performance organisationnelle recherché.
Ensuite, plutôt qu’une transformation globale reposant principalement sur l’usage de pratiques Agile, il est préférable de travailler à la mise en place d’une démarche itérative et incrémentale faisant évoluer la culture de l’organisation, simplifiant le travail quotidien et alignant ce travail sur la stratégie de l’organisation.
Qu’est-ce que Scrum ?
Scrum par Scrum.org et par Scrum Alliance est un framework qui met en œuvre les valeurs et principes du Manifeste Agile. À travers 3 rôles, 3 artefacts et 5 rituels, ce framework permet à des équipes multidisciplinaires et autonomes de se concentrer sur la réalisation itérative d’un incrément de valeur « Produit ». Sa mise en œuvre est soutenue par 5 valeurs (courage, focus, ouverture, respect et engagement) et une approche empirique d’amélioration continue.
Qu’est-ce qu’un Scrum Master ?
Le Scrum Master est l’un des 3 rôles du framework Scrum. Son objectif principal est d’aider l’équipe Scrum à progresser. Pour cela, il est le garant du respect du framework Scrum par l’équipe. Formateur, facilitateur, coach et mentor, il est chargé de lever les obstacles rencontrés par l’équipe Scrum et est un agent de changement au sein de l’organisation.
Que désigne la notion d’artefact Scrum ?
Les trois artefacts Scrum (Product Backlog, Sprint Backlog et Incrément) ont pour but d’aider l’équipe à gérer son travail (priorisation par la valeur, planification et suivi de l’avancement). Ainsi, toutes les parties prenantes impliquées dans le produit peuvent voir ce que l’équipe accomplit. D’autres pratiques Agile, comme l’objectif de Sprint, le Burndown Chart et la Definition of Done, viennent enrichir le framework Scrum lorsque le contexte le nécessite.
Qu’est-ce que l’approche Kanban, quand et pourquoi l’utiliser ?
Le framework Kanban, qui trouve ses racines dans les approches Lean et TPS (Toyota Production System), regroupe un ensemble de pratiques Agile visant à optimiser le flux de création de valeur. Basé sur le management visuel, Kanban se concentre sur la réduction du travail en cours et la diminution des temps d’attente, afin d’accélérer le Time to Market, c’est-à-dire le temps qui sépare la prise en compte d’un besoin et sa mise en œuvre dans une expérience utilisateur.
Qu’est-ce que l’Extreme Programming (XP) ?
XP est un framework Agile qui traduit un style de développement logiciel mettant l’accent sur l’excellence des techniques de programmation, une communication simple et efficace (3C) et la recherche des solutions les plus simples possibles. Cela se traduit par des valeurs et pratiques de développement logiciel reconnues telles que le Peer Programming, la Collective Code Ownership, le Test Driven Development et l’intégration continue.
Qu’est-ce que le Scaled Agile Framework® (SAFe®) ?
SAFe est un framework de mise à l’échelle de l’agilité qui intègre de nombreuses pratiques Lean, Agile et DevOps. Il propose plusieurs configurations possibles pour s’adapter aux différents niveaux de complexité des organisations. Sa mise en œuvre vise à aligner les efforts de 50 à 125 collaborateurs sur une même intention de création de valeur, les Agile Release Trains ou ART. SAFe se caractérise également par de nouveaux rôles et rituels (RTE & PI Planning).
Quels sont les bénéfices de la mise en place d’un framework Agile ?
Les principaux bénéfices d’un framework Agile sont :
- Se concentrer sur la création de valeur pour l’utilisateur final
- Optimiser le processus opérationnel grâce à une approche empirique soutenant l’amélioration continue (être plus efficace)
- Favoriser l’innovation en amplifiant la dynamique collaborative et l’intelligence collective
Qu’est-ce que le modèle Spotify ?
Le modèle Spotify traduit un schéma d’organisation de l’agilité à l’échelle mis en place au sein de Spotify. Il est composé de Tribes, Squads, Chapters et Guilds. Il vise à optimiser la livraison, la circulation de l’information et le partage des compétences et des connaissances au sein de l’organisation. Il est important de garder à l’esprit que Spotify a construit ce modèle pour ses propres besoins, et non pour inciter d’autres entreprises à appliquer le même modèle. Henrik Kniberg, coach Agile chez Spotify, a d’ailleurs indiqué que le chemin qui a conduit Spotify à ce modèle est bien plus important que le modèle lui-même.
Qu’est-ce que l’approche VSM (Value Stream Mapping) ?
Une chaîne de valeur représente la séquence d’activités qu’une organisation doit réaliser pour concevoir, mettre en œuvre et livrer une demande client. Elle implique un double flux d’information et de matière. Le Value Stream Mapping offre une vision globale et mesurée de la manière dont le flux de création de valeur est opéré au sein d’une organisation. C’est une pratique très efficace pour établir des décisions stratégiques d’optimisation organisationnelle.
Qu’est-ce que la pensée Lean ?
La pensée Lean traduit une démarche d’amélioration des organisations à travers 5 principes principaux :
- Spécifier précisément la valeur créée pour un produit donné ;
- Identifier la chaîne de valeur de chaque produit ;
- Éliminer toutes les interruptions possibles dans le flux de création de valeur ;
- S’assurer que la demande client déclenche la création de valeur ;
- Et s’inscrire dans une quête de perfection à travers un processus d’amélioration continue.
Qu’est-ce que le Lean Startup (Eric Ries) ?
Le Lean Startup se caractérise par la validation rapide et peu coûteuse des hypothèses de création de valeur. Cette approche se traduit par la réalisation d’un MVP (Minimum Viable Product) et un cycle d’apprentissage itératif (Build – Measure – Learn) qui conduit à un processus de décision tel que : Continuer – Pivoter – Abandonner.
Que sont les OKR (Objectives & Key Results) ?
Les OKR sont une approche de formalisation des objectifs et des résultats clés visant à aligner les efforts opérationnels d’une organisation sur ses intentions stratégiques. Chaque objectif (stratégique ou opérationnel) reflète la qualification d’un but à atteindre, tandis que les résultats clés reflètent la quantification de l’atteinte d’un objectif donné. Les résultats clés servent à évaluer les progrès réalisés dans l’atteinte de l’objectif, à travers un cycle d’OKR d’une durée de 3 mois.
Kubernetes
Qu’est-ce que Kubernetes ?
Kubernetes, également connu sous le nom de Kube ou K8s (prononcé « Kates »), est une plateforme open source d’orchestration de conteneurs. Développée à l’origine par Google, Kubernetes automatise le déploiement, la mise à l’échelle et la gestion des applications conteneurisées, dans des environnements cloud privés, publics et hybrides. Intégré en mars 2016 par la Cloud Native Computing Foundation (CNCF), qui fait partie de la fondation à but non lucratif Linux Foundation, Kubernetes est classé comme un projet « Graduated », gage d’un niveau global de maturité, notamment en termes de diversité des contributions et d’adoption par la communauté.
Comment fonctionne Kubernetes ?
Kubernetes gère automatiquement les besoins variables de chaque conteneur exécuté sur un groupe de serveurs, ou « cluster », en allouant dynamiquement les ressources nécessaires.
Grâce à des sondes (probes), Kube est par exemple capable de déterminer si votre application a besoin d’être redémarrée, doit être déplacée sur un autre nœud (pour mieux gérer les capacités de ressources) ou s’il est nécessaire de créer une ou plusieurs instances supplémentaires pour mieux gérer la charge.
Tous les comportements de k8s sont décrits via des fichiers YAML ou JSON ingérés par un centre de contrôle qui informe et déclenche les actions nécessaires.
Kubernetes cherche continuellement à réconcilier l’état désiré, décrit par ces fichiers YAML, avec l’état réel de ce qui est déployé.
Quelle architecture mettre en place pour supporter Kubernetes ?
L’architecture d’un cluster Kubernetes se décompose généralement en 2 parties : le centre de contrôle (API Server, Scheduler, les Controllers et la base etcd), appelé « Control Plane », « Master Nodes » ou « Server Nodes », et les nœuds de travail, appelés « Worker Nodes » ou « Agent Nodes ».
Les nœuds peuvent être des VM (machines virtuelles) ou des serveurs physiques dans lesquels s’exécutent les conteneurs, représentés par une notion logique : le Pod.
L’API Server est le point central de toutes les communications administratives du cluster, permettant d’interagir avec lui via des commandes et des fichiers Manifest (en YAML ou JSON) qui seront interprétés par les Controllers pour s’assurer que les objets k8s sont créés et correspondent à l’état désiré, stocké dans la base de données de Kubernetes appelée ETCD. Le Scheduler est chargé de déployer les pods sur les bons nœuds kube en fonction de la disponibilité des ressources (CPU, RAM,…) et des contraintes de placement définies.
Les « Worker Nodes » ou « Agent Nodes » contiennent, en plus des pods applicatifs, 2 composants importants : Kubelet et Kube-proxy.
Kubelet est le composant qui surveille, arrête et démarre les conteneurs ; il reçoit ces instructions du Scheduler et des Controllers via l’API Server. Kube-proxy est un proxy réseau qui gère les communications réseau à l’intérieur et à l’extérieur du cluster.
Comment déployer un cluster Kubernetes ?
Kubernetes est composé de différents éléments (API Server, un Scheduler, des Controllers, une base etcd, Kubelet, Kube-proxy, …) qui sont chacun des binaires devant être déployés sur des VM ou des machines physiques.
Selon les distributions Kubernetes on-premise (Vanilla, RedHat OpenShift, Rancher RKE ou K3S, VMWare Tanzu, D2iQ, Nutanix Karbon, …) ou les Kubernetes managés dans le cloud (Amazon EKS, Microsoft AKS, Google GKE, Exoscale Kubernetes, OVHcloud Kubernetes, …), les étapes d’installation et de configuration diffèrent.
Ces installations ou configurations peuvent être réalisées via des outils IaC (Infra-as-Code) comme Ansible ou Terraform, via des scripts personnalisés ou, plus récemment, via la Cluster API (CAPI) qui permet de gérer le cycle complet d’un cluster k8s.
Quel est le rôle d’un Pod Kubernetes ?
Un pod est la plus petite unité de ressources déployable sur un nœud, partageant des ressources telles que le stockage et l’accès réseau. Un pod est donc une définition logique qui peut contenir 1 ou plusieurs conteneurs applicatifs partageant des ressources de stockage ainsi qu’une même identité réseau (adresse IP), ainsi qu’un certain nombre de configurations influençant la manière dont les conteneurs s’exécutent.
Qu’est-ce qu’un cluster Kubernetes ?
Un cluster est un ensemble de nœuds, ou machines de travail, sur lesquels s’exécutent les applications conteneurisées. Ces nœuds peuvent être des machines physiques ou des machines virtuelles.
Quelle est la différence entre Kubernetes et Docker ?
Docker est une entreprise qui développe, entre autres, un produit du même nom permettant de construire et d’exécuter des conteneurs de manière unitaire sur une machine.
Kubernetes se positionne au-dessus, en tant qu’orchestrateur de conteneurs, pour gérer le cycle de vie d’un ensemble de conteneurs sur plusieurs machines (virtuelles ou physiques). Pour cela, Kubernetes s’appuie sur la « Runtime specification » de l’Open Container Initiative, avec 2 implémentations phares : Containerd et CRI-O.
Lorsqu’on compare Docker et Kubernetes, on parle souvent de « Pet vs Cattle » pour exprimer la différence de traitement entre un animal de compagnie, auquel on donne un nom, un lieu de résidence, et que l’on traite avec beaucoup d’attention, et du bétail, géré de manière plus industrielle.
Quelle est la différence entre Kubernetes et des distributions comme OpenShift, Rancher ou Tanzu ?
Kubernetes est un système open source dont il existe plusieurs implémentations.
Des implémentations on-premise telles que :
- Vanilla : il s’agit de la distribution open source de base
- RedHat OpenShift
- Rancher RKE ou K3S
- VMWare Tanzu
- Nutanix Karbon
- D2iQ
- …
Ou des implémentations managées dans le cloud telles que :
Ces listes ne sont en aucun cas exhaustives, mais représentent une bonne partie du marché actuel. Notez également que toutes ces distributions sont certifiées par la Cloud Native Computing Foundation (CNCF), la fondation qui gère Kubernetes.
Quelles sont les fonctionnalités de la distribution Kubernetes OpenShift de Red Hat ?
Contrairement à Kubernetes, projet open source, la solution Red Hat OpenShift est un produit commercial nécessitant un contrat d’abonnement payant.
En plus d’un service de support, la solution Red Hat OpenShift intègre une version du projet Kubernetes certifiée par la Cloud Native Computing Foundation, avec un ensemble de composants et services additionnels orientés vers les solutions d’entreprise, avec un fort accent sur la sécurité.
Elle inclut des pipelines CI/CD (projet Tekton), une solution GitOps (ArgoCD), un Service Mesh (Istio), une solution d’observabilité (Prometheus, Grafana, EFK), des fonctions serverless et de virtualisation, ainsi que de nombreuses autres fonctionnalités.
Pour en savoir plus sur Red Hat OpenShift : https://www.redhat.com/fr/technologies/cloud-computing/openshift/features
Pourquoi déployer Kubernetes ?
Conçus pour regrouper et exécuter des applications, les conteneurs doivent être gérés pour éviter les interruptions de service.
La mise en place de Kubernetes permet une gestion résiliente des systèmes distribués à base de conteneurs et une architecture hautement disponible.
Par exemple, Kubernetes permet l’équilibrage de charge et la répartition du trafic réseau pour stabiliser le déploiement lors des pics de trafic.
De plus, Kubernetes offre la capacité de déployer et d’exploiter des applications cloud-native quel que soit l’environnement, que vous soyez hébergé sur un cloud public (comme Google Cloud, AWS ou Microsoft Azure), un cloud privé ou une architecture locale.
Kubernetes gère également l’automatisation du retour à un état stable, le redémarrage des conteneurs en échec, l’arrêt de ceux qui n’offrent pas le niveau de performance souhaité. Kubernetes est aujourd’hui un standard de facto qui apporte une manière homogène et standardisée de déployer et de gérer des conteneurs. Par sa manière d’être déclaré et de fonctionner, c’est aussi une solution qui facilite la mise en place d’approches DevOps ou DevSecOps.
Toutes les applications peuvent-elles fonctionner dans Kubernetes ?
En théorie, un conteneur peut exécuter n’importe quelle application et être orchestré par Kubernetes.
En pratique, les choses sont plus compliquées car, pour tirer pleinement parti des fonctionnalités de Kubernetes telles que la scalabilité, la haute disponibilité, l’observabilité, la sécurité, … il est nécessaire d’architecturer et de développer vos applications d’une certaine manière : c’est ce qu’on appelle les Cloud Native Applications (CNA).
Pour des raisons de coût, il n’est pas toujours possible de refondre complètement une application, mais il est possible de l’adapter pour en faire une « Cloud Ready Application ».
Les applications legacy peuvent être conteneurisées avec peu d’effort pour au moins bénéficier du déploiement standard d’un conteneur et de la gestion de son cycle de vie, sans, par exemple, tirer parti du scaling…
Quels sont les bénéfices offerts par Kubernetes ?
Dans une perspective d’optimisation d’un environnement avec des applications cloud-native, le principal bénéfice de la solution Kubernetes est réellement l’orchestration automatisée des conteneurs et l’élimination du facteur humain. De plus, le fait que seul le serveur maître soit administré, et non chaque nœud individuellement, facilite son usage et permet de gagner un temps considérable tout en limitant le risque d’erreurs associées.
L’automatisation de l’allocation élastique de ressources supplémentaires (autoscaling), la gestion dynamique du trafic, la redondance et la résilience offertes par une plateforme Kubernetes permettent de répondre aux enjeux d’industrialisation des directions IT tout en garantissant l’agilité des opérations et du business (fiabilité et accélération du « time to market » des applications).
Enfin, la portabilité de Kubernetes offre une réelle indépendance vis-à-vis des plateformes et donc des opérateurs Cloud, facilitant le changement de fournisseur. Kubernetes, parfaitement aligné avec une approche DevOps, se positionne donc comme l’orchestrateur de conteneurs de référence, apportant un standard de facto à la gestion de l’ensemble du cycle de vie des conteneurs, du développement à la production.
Quel avenir pour Kubernetes ?
La Cloud Native Computing Foundation (CNCF) porte le projet Kubernetes depuis 2016, projet considéré comme « Graduated » (le plus haut niveau de maturité des projets CNCF).
Grâce à cette fondation, Kubernetes évolue régulièrement en proposant de nouvelles versions tous les 4 mois, apportant soit de la stabilité, soit de nouvelles fonctionnalités.
K8s prend une importance croissante dans les entreprises de toutes tailles et permet de répondre à des besoins de plus en plus variés. La création de multiples clusters devrait devenir une commodité, qu’ils soient On-prem, Multi-Cloud ou Hybrid-cloud, avec des approches « plateforme » pour des déploiements à grande échelle. Des domaines comme la virtualisation de VM dans Kube, le MLOps (Machine Learning), l’IA (Intelligence Artificielle) ou la Blockchain devraient prendre une importance croissante.