Introduction aux Operators Kubernetes
Introduction
Comme vous le savez déjà, Kubernetes est un orchestrateur de conteneurs très populaire. Vous pouvez utiliser ses fonctionnalités pour déployer vos applications, et il se chargera de nombreuses tâches comme le scaling, les rollouts et rollbacks, ou encore l’auto-guérison (self-healing) décrite ci-dessous.
Pour cela, vous écrirez des manifestes au format YAML (deployments, services, configmaps, etc.) pour chacune de vos applications, afin d’indiquer à Kubernetes ce qu’il doit créer.
Ces applications peuvent être stateful ou stateless.
Petit rappel : un processus ou une application stateless ne conserve pas les données client générées lors d’une session pour les réutiliser lors de la session suivante avec ce même client. Il n’y a aucune connaissance stockée ni référence aux transactions passées.
À l’inverse, les applications stateful peuvent être sollicitées à plusieurs reprises. Elles s’exécutent dans le contexte des transactions précédentes, et la transaction en cours peut être affectée par ce qui s’est passé auparavant.
Exemples :
- Application stateful : une boutique en ligne où, à chaque fois que vous sélectionnez un article et l’ajoutez à votre panier, l’état de ce panier doit être conservé.
- Application stateless : une application utilisée uniquement pour rechercher une information dans une base de données (par exemple, un service de prévisions météo). L’état précédent n’a pas d’importance ici, car les données sont stockées ailleurs.
Pour gérer des applications stateful dans Kubernetes, vous aurez évidemment besoin de plus de “personnes” tout au long de leur cycle de vie.
Par exemple, si vous avez plusieurs répliques MySQL, chacune aura son propre état, et vous ne pourrez pas les mettre à jour dans n’importe quel ordre : toutes les répliques doivent communiquer en permanence entre elles pour garantir la cohérence des données. De plus, encore davantage d’opérations manuelles seront nécessaires lors du scaling up ou du scaling down, comme la configuration réseau pour les nouvelles répliques ou la gestion des données des répliques supprimées.
Cela signifie que, pour ce type de configuration, vous aurez besoin de personnes et de compétences pour opérer ces applications !
Et c’est précisément pour cela que les Operators existent !
Le rôle des Operators
Vous pouvez voir les Operators comme des “ingénieurs” qui encoderaient sous forme logicielle les compétences d’un administrateur expert, afin de réaliser des actions telles que : comment déployer l’application, comment la restaurer, ou comment créer un cluster de mon application ?
Tout comme les charts Helm, les Operators Kubernetes packagent également des applications en bundles faciles à déployer, mais ils vont bien au-delà ! (nous verrons plus loin en quoi ils peuvent être complémentaires)
En effet, vous pouvez utiliser les Operators Kubernetes pour, par exemple, déployer une application stateful et son schéma de base de données de manière totalement automatique, ou déployer une application sur un cluster configuré d’une manière particulière pour garantir une haute disponibilité !
Considérez les Operators comme un excellent moyen de rendre les choses réutilisables et automatisées pour les applications stateful.
Comment fonctionnent les Operators ?
Les Operators fonctionnent en étendant le control plane et l’API de Kubernetes. Dans sa forme la plus simple, un Operator ajoute un endpoint à l’API Kubernetes, appelé custom resource definition (CRD), ainsi qu’un composant du control plane qui surveille et maintient les ressources de ce nouveau type.
La façon la plus courante de déployer un Operator consiste donc à ajouter la Custom Resource Definition et son Controller associé à votre cluster, comme décrit ci-dessous :
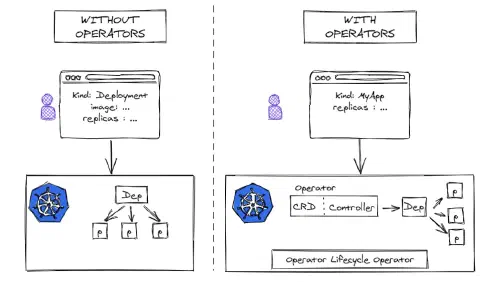
Ainsi, les Operators disposent du même type de boucle que Kubernetes :
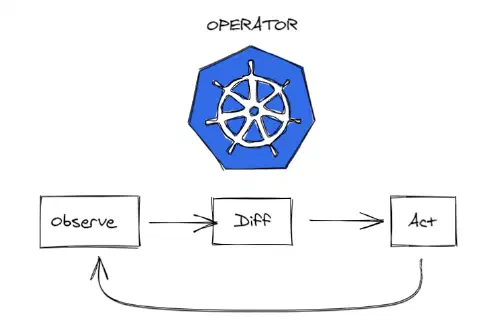
Ils vérifient les mises à jour du fichier de configuration, détectent les changements ou les erreurs, et agissent en conséquence !
Helm vs Operators ?
Quand j’ai découvert les Operators, j’étais un peu confus par rapport à Helm, les deux me paraissant être des moyens de templating d’applications.
Il ne faut pas voir Helm et les Operators comme des concurrents, mais comme des outils complémentaires, à utiliser selon différents cas d’usage !
Avec Helm, vous pouvez packager vos applications, un peu comme un package RPM sous Linux ! Vous pouvez donc continuer à utiliser Helm pour déployer une application simple, lorsque peu de personnalisations sont nécessaires.
Cependant, vous aurez toujours besoin des Operators pour réaliser les actions décrites précédemment, comme le déploiement d’applications stateful. L’Operator gérera alors un ensemble d’instances, en réconciliant leur état conformément aux spécifications mentionnées dans sa CR.
Helm ne peut pas faire cela.
Cela dit, vous pouvez les rendre complémentaires en implémentant vous-même vos Operators, manuellement ou via différents frameworks !
Comment créer des Operators ?
Vous pouvez créer manuellement des Operators à l’aide d’un Operator SDK, qui permet de construire des applications natives Kubernetes. L’Operator SDK, un projet incubé par la Cloud Native Computing Foundation (CNCF), simplifie grandement la gestion des Operators en fournissant les outils nécessaires pour construire, tester et packager des Operators.
Le SDK propose actuellement trois options pour construire un Operator :
- Go
- Ansible
- Helm
Voici une liste de frameworks que vous pouvez utiliser pour implémenter vos propres Operators :
- Operator-framework (CoreOS) : https://github.com/operator-framework
- Kudo (D2iQ) : https://github.com/kudobuilder/kudo
- Kubebuilder (groupe Kubernetes SIGs) : https://github.com/kubernetes-sigs/kubebuilder
Pour conclure, vous pouvez trouver des Operators écrits par la communauté via les liens suivants :
À découvrir !
Les capacités des Operators
Dans le schéma ci-dessous, on constate que les Operators construits avec Helm ne sont capables que de gérer l’installation et les mises à jour, tandis qu’Ansible et Go permettent de gérer l’intégralité du cycle de vie d’un système.
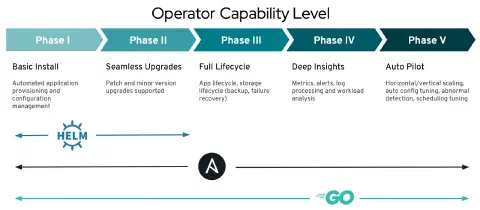
Source : https://sdk.operatorframework.io/docs/advanced-topics/operator-capabilities/operator-capabilities/
Voici un exemple pour chaque niveau de capacité, afin de mieux comprendre leur signification :
- Basic Install : un Operator déploie une base de données via des objets Deployment, ServiceAccount, RoleBinding, Configmap, PersistentVolumeClaim et Secret, tout en initialisant une base de données vide.
- Seamless Upgrades : un Operator peut mettre à niveau une base de données existante vers une version plus récente sans perte de données.
- Full Lifecycle : un Operator offre la possibilité de créer une sauvegarde des données.
- Deep Insights : un Operator analyse les logs de la base de données, comprend les événements de log et génère des alertes.
- Auto Pilot : un Operator surveille la charge des requêtes sur la base de données et scale automatiquement, à la hausse ou à la baisse, des répliques secondaires en lecture seule.
Exemple d’Operator
Un excellent exemple d’Operator serait Portworx dans le domaine du stockage cloud native. Cette solution de stockage cloud native offre haute disponibilité, protection des données et sécurité pour les applications conteneurisées. Elle permet de migrer des applications entières, avec leurs données, entre clusters, à l’aide d’une seule commande kubectl !
L’Operator Portworx exporte des métriques qui peuvent être utilisées avec l’Operator Prometheus pour collecter, alerter et afficher des dashboards Grafana de ces données. Cela signifie que l’Operator Portworx atteint la Phase IV (Deep Insight) de capacité.
YAML, Helm, Kustomize, Operators : lequel choisir ?
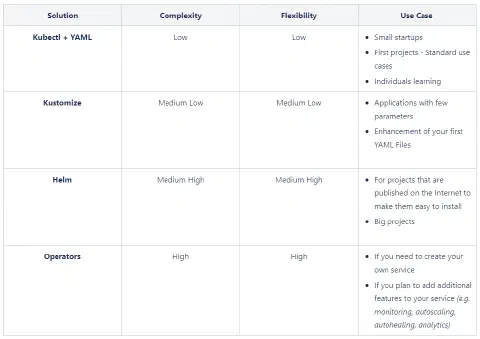
Chaque solution a ses avantages et ses inconvénients.
Comme le montrent le tableau et le graphique ci-dessous, vous pouvez facilement vous faire une idée de leur complexité et de leur flexibilité :
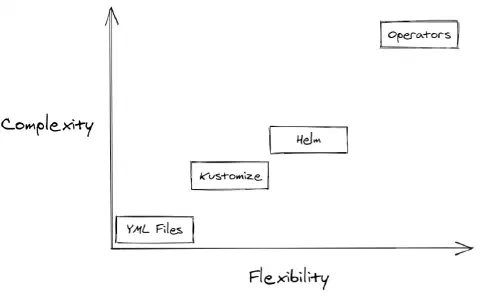
Tableau comparatif
Conclusion
Nous avons vu à quel point les Operators peuvent être intéressants du point de vue de la flexibilité, même s’ils peuvent s’avérer complexes. Ils peuvent être utilisés comme méthode de packaging, de déploiement et de gestion d’une application Kubernetes. L’attribut clé d’un Operator est la gestion de l’application, incluant l’installation, les mises à jour, les sauvegardes, les insights ou le scaling !
Il est intéressant de noter que les Operators ne sont pas utilisés de la même manière selon les distributions Kubernetes.
D’un côté, Openshift utilise les Operators pour tout, apportant ainsi une connaissance opérationnelle aux applications déployées. Ils utilisent même des Operators pour configurer l’interface web d’Openshift !
De l’autre côté, Rancher fait le choix inverse, offrant plus de flexibilité, ce qui peut s’avérer plus simple pour les administrateurs puisqu’il ne repose pas sur les Operators pour tout.
Pour aller plus loin, découvrez notre formation Kubernetes et l’accompagnement de nos experts Kubernetes.