GitOps et le dilemme du millefeuille
Dans cet article, co-écrit avec Sébastien Féré, nous décrivons ce qu’est GitOps, ses impacts dans l’entreprise et un exemple de mise en œuvre.
Pour les francophones, nous avons donné une conférence aux DevOpsDays Geneva 2020, présentant GitOps comme une manière de gérer les clusters K8s et les machines virtuelles en entreprise :
GitOps, depuis sa création en août 2017 par Alexis Richardson, CEO de WeaveWorks, repose sur 4 piliers :
- Déclaratif : l’ensemble du système est décrit de manière déclarative
- Git comme source unique de vérité : les changements déclaratifs permettent de considérer chaque modification comme une transaction
- Opérateur Kubernetes : les changements approuvés vers l’état désiré sont automatiquement appliqués au système
- Observabilité continue : des agents logiciels garantissent la conformité et alertent en cas de divergence
GitOps - Push ou Pull ?
Depuis l’apparition du DevOps en 2010, les options de déploiement en push et en pull ont toujours été sur la table. Cependant, pour de bonnes ou de mauvaises raisons (l’idée de garder le contrôle étant la plus courante), le déploiement basé sur le push reste la méthode privilégiée dans la plupart des entreprises.
L’approche pull, celle d’origine de GitOps
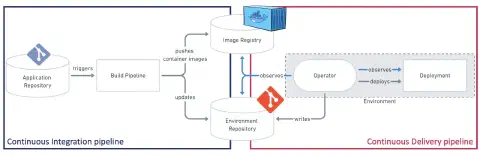
source: based on the diagram from gitops.tech
Avec l’approche pull, l’Operator situé à l’intérieur du cluster Kubernetes est chargé d’écouter les nouveaux événements provenant du dépôt Git (contenant le manifeste de déploiement) et du registre d’images Docker. Lorsqu’un nouveau commit ou une nouvelle image est produit, l’opérateur compare l’état actuel avec l’état désiré du déploiement et effectue les modifications nécessaires pour atteindre cet état désiré.
Si l’on met de côté les écritures automatisées qui peuvent facilement être réalisées par les pipelines de CI, l’Operator n’a besoin que d’un accès en lecture au registre d’images et au dépôt GitOps.
Le fait d’être à l’intérieur du cluster améliore nettement la sécurité, car on reste dans la « zone de confiance » : aucun identifiant disposant de permissions élevées n’est nécessaire pour accéder au cluster. Cela améliore également l’adressabilité : il n’est pas nécessaire de spécifier l’URL pour cibler le bon cluster, ce qui permet d’éviter des erreurs de déploiement (quelle entreprise n’a jamais ciblé le mauvais environnement lors d’un déploiement ?).
L’approche push, GitOps à mi-chemin
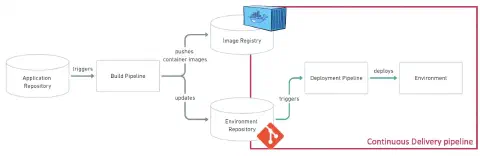
source: based on the diagram from gitops.tech
Avec l’approche push, bien connue et la plus utilisée, le déploiement est réalisé depuis l’extérieur du cluster Kubernetes. Bien qu’elle puisse aboutir au même type de résultat concernant l’état désiré du système, elle n’offre pas la boucle de rétroaction ni l’observabilité fournies par l’Operator. D’un point de vue sécurité, l’approche pull et son Operator sont indéniablement préférables à des identifiants disposant de permissions de haut niveau.
Comme évoqué précédemment, l’approche push reste privilégiée dans la plupart des entreprises et cela ne va pas changer de sitôt. Kubernetes et le Cloud-native occupent une place considérable dans les feuilles de route de transformation digitale, mais les entreprises disposent également d’infrastructures historiques. Alors que les applications migrent vers Kubernetes, les bases de données ou les workloads Windows, par exemple, sont susceptibles de rester sur des machines virtuelles pendant encore plusieurs mois. Dans ce contexte, en complément de Helm, des outils DevOps comme Ansible restent très pratiques.
Si les pipelines CI/CD sont souvent décrits comme un processus linéaire, l’approche GitOps soutient également que le CI et le CD peuvent être séparés en deux processus distincts, aussi bien en pull qu’en push. Dans certains cas, il est intéressant de considérer un ensemble de microservices, ou un produit, comme une unité de déploiement unique. Avec GitOps, il devient possible de gérer des déploiements dans différents clusters selon la branche Git, de manière entièrement déclarative !
GitOps en entreprise
Dans le cadre de leur transformation digitale, de nombreuses entreprises adoptent les méthodologies DevOps ainsi que de nouvelles technologies telles que les conteneurs, Kubernetes et le Cloud. Le premier jalon majeur est sans conteste la mise en production d’une application métier utilisant Git comme source unique de vérité pour décrire les ressources Kubernetes telles que :
- Namespaces
- Deployments
- Services
- Volumes & PersistentVolumes
- Roles & RoleBindings
- Network Policies
- Quotas, Limits,
- …
Avec Kubernetes, toutes ces ressources font partie de la même unité de déploiement (ou de deux : une pour les ressources globales et les namespaces, une pour les ressources propres au namespace) et elles coexistent dans le même dépôt Git.
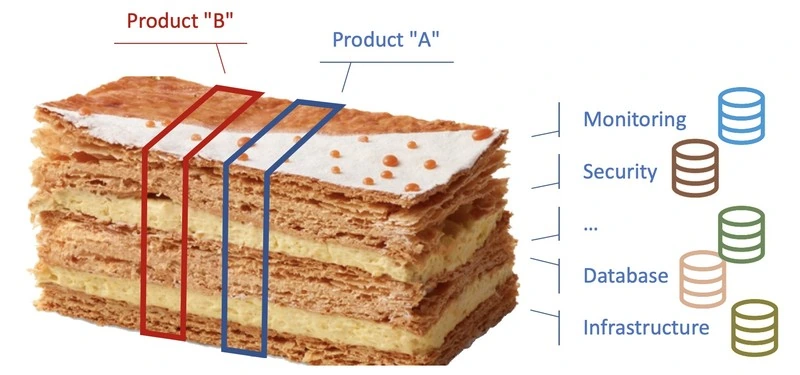
La propriété et la responsabilité des ressources Kubernetes, ou de leur équivalent, sont aujourd’hui réparties entre les différents départements IT de l’entreprise : c’est ce que nous appelons le « millefeuille »…
Le millefeuille
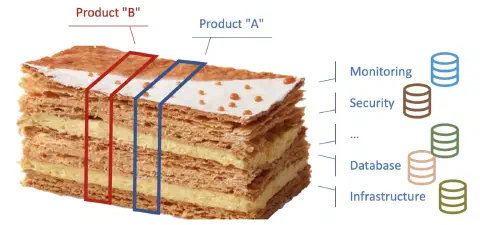
source: based on the interpretation of the millefeuille by Jean-François Piège
Plutôt qu’une représentation classique des services IT ou des départements sous forme de silos, représentons-les comme les couches indépendantes de la célèbre pâtisserie française appelée « millefeuille ». Dans la plupart des entreprises, les politiques, les outils et la gouvernance existants, hérités des pratiques ITIL, font que chaque département IT dispose de ses propres outils et, évidemment, de sa propre source de vérité selon son point de vue.
Par exemple, l’équipe base de données dispose généralement d’un inventaire des bases de données, tandis que l’équipe réseau dispose d’un outil pour gérer les équipements réseau et l’ensemble des règles et politiques associées, sans aucune connexion entre ces deux référentiels.
Avec le « millefeuille », chaque couche est indépendante et représente un département IT ayant son propre domaine et sa propre responsabilité, ce qui conduit à des sources de vérité partielles au sein des équipes. Au final, un déploiement complet n’est qu’une succession de tickets et de files d’attente indépendants, d’actions manuelles, etc. Résoudre un incident en production nécessite souvent de reconstruire la connaissance du produit concerné.
Grâce au concept de « context wagon », les enjeux liés au troubleshooting ont été particulièrement bien décrits dans la présentation Operations: The Last Mile Problem For DevOps de Damon Edwards lors du DevOps Enterprise Summit London 2018.
Même si ces problématiques relèvent davantage du DevOps que du GitOps à proprement parler, la manière de penser GitOps subira le même fardeau organisationnel et les mêmes démons du passé. Dans ce contexte, Kubernetes et GitOps ne sont qu’un phare de plus indiquant aux entreprises pourquoi et comment faire évoluer leur approche du provisionnement déclaratif de l’infrastructure, de la gestion des environnements et des changements, etc., mais aussi adopter une vision centrée sur le produit, également largement promue par les méthodologies agiles.
Il existe cependant une différence majeure :
- L’agilité et le DevOps promeuvent une méthodologie, une manière de penser trop facilement remodelée par les entreprises ou les personnes qui ne souhaitent pas réellement embrasser l’approche.
- Les ressources Kubernetes et GitOps offrent un outil, un dépôt Git, pour centraliser l’ensemble de la configuration d’un produit. Un outil implique une interface, une CLI, une API qui ne peuvent pas être détournées aussi facilement que des idées ou des principes.
Il existe de nombreuses options pour impliquer chaque équipe dans le processus de déploiement « GitOps », en s’appuyant sur les outils de collaboration Git tels que les revues et approbations de Pull-Request ou Merge-Request. Par exemple, les équipes sécurité et réseau peuvent participer à la revue et à l’approbation des pull requests liées aux ressources NetworkPolicy. Pour un processus plus fin, le plugin CodeOwner pour Git peut aider à définir des personnes ou des équipes responsables de fichiers spécifiques dans un dépôt.
GitOps et pipeline de livraison
Le meilleur des deux mondes
Les déploiements Kubernetes sont toujours décrits comme une transaction unique avec l’API Server via la CLI kubectl. Cependant, que ce soit dans le Cloud ou on-premise, les déploiements en entreprise impliquent généralement des API, des endpoints ou des moteurs externes à configurer.
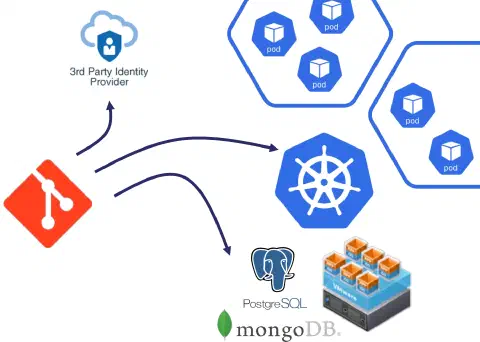
Compte tenu des différents systèmes à configurer en plus des workloads Kubernetes, le schéma ci-dessous représente une option sérieuse pour mettre en œuvre le pipeline de CD :
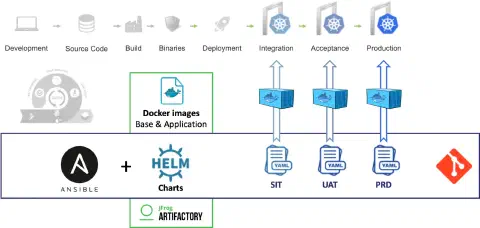
Une approche GitOps en push a été utilisée, combinant Ansible et Helm, pour déployer des applications dans les différents environnements Kubernetes ainsi que sur l’infrastructure historique.
Le pipeline de CI produit les images Docker et les publie dans un registre de conteneurs. Ce n’est pas l’objet de cet article de décrire comment construire des images Docker prêtes pour l’entreprise ou de passer en revue l’organisation des registres Docker, mais gardez à l’esprit qu’il s’agit également d’un aspect très important de l’approche DevSecOps, pour apporter automatisation et sécurité tout au long du pipeline CI/CD.
Helm a été utilisé au départ, mais dans le contexte de certains projets, nous avons décidé de le retirer.
Pas pour des raisons de sécurité : Helm v2 avec Tiller n’était pas un problème de sécurité (contrairement à ce que l’on entend souvent), grâce à l’approche Tillerless. D’ailleurs, Helm v3 n’utilise plus Tiller du tout.
Légèreté et simplicité globale
Bien que Helm soit très populaire dans l’écosystème Kubernetes, nous avons décidé de ne pas l’utiliser dans le cadre de cette histoire. Pourquoi ?
- Temps et gestion de l’empaquetage : ce n’est pas un problème majeur, mais les charts Helm doivent être empaquetés, ce qui ajoute un pipeline de CI supplémentaire.
- Umbrella charts : l’un de nos objectifs était de pouvoir créer des charts de base (springboot, nodejs, Angular, PostgreSQL, etc.) et des charts globaux les combinant. C’est assez difficile à réaliser à cause de la manière dont Helm gère la configuration.
- Pas uniquement pour Kubernetes : Helm est un outil dédié aux environnements Kubernetes et personne ne l’utiliserait en dehors de ce contexte. Il faut donc un second outil de configuration pour gérer les configurations et déploiements hors Kubernetes.
- Fonctionnalités redondantes : Helm peut gérer le cycle de vie de votre application, fournir un versionnement, effectuer des rollbacks, etc. Avec GitOps, le cycle de vie est géré par l’état du dépôt Git, qui offre également bien d’autres capacités comme la traçabilité, l’audit, le diff, etc.
- 1 vaut mieux que 2 : en matière d’adoption, de courbe d’apprentissage, de maintenance, etc., moins c’est mieux que plus. Bien que légèrement différents, Helm et Ansible sont finalement deux outils de configuration et de déploiement, avec par exemple deux approches différentes du templating (Go templating contre Jinja2).
Helm ou les opérateurs Kubernetes conviennent parfaitement aux éditeurs de logiciels pour distribuer leurs offres packagées et donner à leurs utilisateurs ou clients un moyen simple et standardisé de configurer et déployer la solution.
Même si Ansible n’est peut-être pas la meilleure option pour les déploiements Kubernetes (module k8s), il prend tout son sens dans l’histoire de l’entreprise en matière de GitOps et de déploiements en push sur machines virtuelles et clusters Kubernetes.
Comme pour toute conception et toute décision, nous mettons sur la table des opinions valables dans un espace (notre contexte d’entreprise) et un temps (avant l’arrivée de Helm 3) donnés.
L’entreprise veut des standards
Tout comme Helm, Ansible a la capacité de créer des templates de ressources Kubernetes… mais pourquoi créer des templates ?
Chaque entreprise développant des logiciels dispose d’un ensemble de pratiques, d’outils et de frameworks communs :
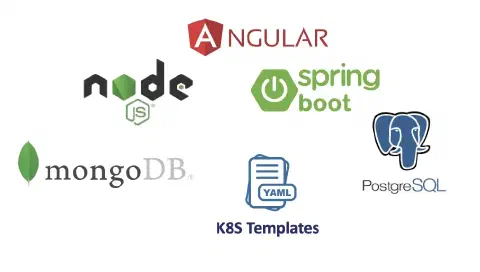
Certaines personnes détestent les frameworks ou les scripts qui masquent la complexité derrière ce que l’on appelle la « magie noire ». Pourtant, il est nécessaire d’apporter des standards à l’entreprise pour :
- La réutilisabilité
- Les conventions, y compris le labelling
- La sécurité
- Les limites et quotas par défaut
- La segmentation réseau par défaut
- La configuration par défaut
- …
Que ce soit avec Helm ou Ansible, il faut décider du degré de liberté accordé au templating. Que expose-t-on ? Que permet-on de surcharger sans enfreindre les règles de l’entreprise ou de sécurité ?
Ces questions trouveraient leurs réponses dans un compromis entre toutes les parties prenantes DevSecOps. Cependant, voici quelques règles de bon sens :
- Garder les templates simples (principe KISS) : identifier les usages et créer différents templates (par exemple, nos templates Kubernetes pour springboot et Angular sont identiques à plus de 90 %)
- Ne pas réinventer la roue : garder les templates aussi proches que possible des ressources, API et syntaxe Kubernetes
Livrer un produit en continu
De nombreuses entreprises ont conçu des microservices pour répondre à des besoins métier, avec plus ou moins de succès, au point que certains proposent aujourd’hui de ne plus utiliser les microservices…
Les monolithes sont l’avenir, car le problème que les gens essaient de résoudre avec les microservices ne correspond pas vraiment à la réalité. Kelsey Hightower
Cela dit, une capacité essentielle, celle de déployer des microservices de manière totalement indépendante les uns des autres, n’est peut-être pas pleinement respectée dans le contexte du déploiement de microservices en entreprise. En ajoutant à cela des releases peu fréquentes et un processus de mise en production complexe, on finit par déployer les microservices comme une pile monolithique, ce qui semble être un contre-exemple total au premier abord, mais qui peut avoir du sens dans une approche déclarative centrée sur le produit…
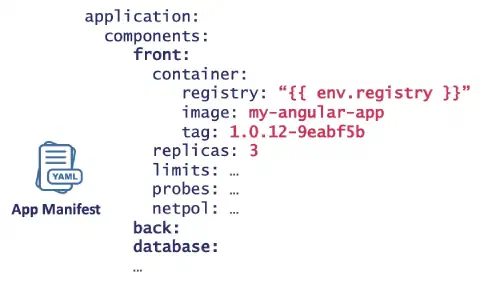
Avec l’approche entièrement déclarative de Kubernetes et GitOps, il est intéressant de maintenir un manifeste applicatif complet et cohérent du produit, en s’appuyant sur les templates d’entreprise décrits dans la section précédente.
Que ce soit avec Ansible ou la conception idempotente de Kubernetes, un nouveau déploiement de l’ensemble du produit n’applique que les changements résultant de la comparaison entre l’état GitOps désiré et l’état actuel du système.
L’approche GitOps impose un manifeste du produit déclaratif, complet, versionné et cohérent, ce qui ferait le bonheur de n’importe quel Release ou Environment Manager.
Conclusion
Le chemin vers Kubernetes tend à être long et fastidieux, car il implique de nombreux changements : applications cloud-native, chaîne d’outils CI/CD, provisionnement de l’infrastructure et des environnements, connaissance des conteneurs et de l’orchestration, processus opérationnels, etc. Mais tout voyage commence par un premier pas dans la bonne direction !
L’approche déclarative, portée par le mouvement DevOps et renforcée par Kubernetes et GitOps, apporte une puissance considérable en utilisant Git comme source de vérité et s’intègre assez facilement en entreprise, avec des dizaines d’applications et d’environnements IT. Cette histoire peut être perçue comme une approche GitOps à mi-chemin (basée sur le push) : mais le verre est-il à moitié plein ou à moitié vide ?
Tous ces changements bousculent plus que jamais les certitudes établies, l’outillage existant, la structure organisationnelle et les personnes. De nombreux défis et solutions ont été identifiés au cours de notre parcours, dans lequel la sécurité et l’automatisation occupent une place centrale.
Quelques sujets ont été volontairement mis de côté, méritant une réflexion plus large qu’une simple section de cet article :
- La conception d’applications cloud-native
- Les bonnes pratiques pour sécuriser les Dockerfiles
- Le modèle de branches Git pour les dépôts GitOps
- La sécurisation de la livraison et de l’utilisation des packages publics
- La sécurisation de la livraison des images Docker internes grâce à la promotion
- Les pratiques et l’outillage Shift-Left pour le pipeline CI/CD
- L’intégration continue des éléments d’infrastructure, y compris les clusters Kubernetes
- …
Pour aller plus loin, découvrez notre formation ArgoCD et GitOps et notre consulting DevOps.