Comment Kubernetes applique le principe du desired state
Cet article a été initialement publié sur Medium
Le desired state (état désiré) est l’un des concepts fondamentaux de Kubernetes. Via une API déclarative ou impérative (je reviendrai sur cette notion plus loin), vous décrivez l’état des objets (Pod, ReplicaSet, Deployment, …) qui feront tourner les conteneurs.
Kubernetes, via les « Kube controller managers » (qui font partie des composants du master), est chargé de réguler l’état du système. Le composant kubelet (présent sur chaque worker node) reçoit les requêtes et applique la nouvelle configuration pour faire tourner les conteneurs. L’état, la configuration, les API Objects, … sont stockés dans un stockage clé/valeur distribué simple : le cluster etcd.
Si, suite à une panne, un conteneur s’arrête, le kubelet recrée le Pod à partir des informations du desired state stockées dans etcd.
Kubernetes garantit ainsi strictement que tous les conteneurs qui tournent sur le cluster sont toujours dans l’état désiré.
Voici par exemple un objet Deployment Kubernetes simple :
|
Qui est déployé via la commande suivante :
|
Cet exemple très simple met en évidence plusieurs points importants.
Les Deployments (comme les autres objets) de Kubernetes sont déclaratifs : l’utilisateur spécifie le nombre d’instances d’une version donnée d’un Pod à déployer, et Kubernetes calcule les actions nécessaires pour passer de l’état courant à l’état désiré, en déployant ou en supprimant des Pods sur les Nodes.
Si vous connaissez les fichiers de configuration Kubernetes, vous avez déjà remarqué les champs apiVersion et kind au début de chaque fichier, qui décrivent le type d’objet, sa version et son group.
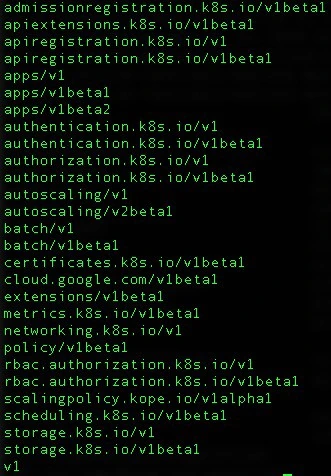
Cela peut prêter à confusion, car vous verrez de nombreuses versions différentes comme apps/v1beta2, apps/v1, etc. et même sans group … Les choses évoluent très vite dans l’univers Kubernetes, la notion de group a été ajoutée plus tard pour faciliter l’extension de l’API Kubernetes et découper le serveur API monolithique en composants plus petits, permettant d’activer ou de désactiver des groupes …
Alors, comment savoir quelles versions utiliser ? Il suffit d’interroger le serveur API via la CLI
|
|
La sémantique de la version et du group est bien expliquée dans la documentation Kubernetes : https://kubernetes.io/docs/reference/using-api/#api-versioning
et si vous voulez lister les ressources « kind » avec leur group API associé, utilisez simplement
|
|
Pour connaître la dernière apiVersion supportée d’une ressource, utilisez la commande kubectl explain StatefulSet ou consultez la documentation de référence de l’API : https://kubernetes.io/docs/reference/#api-reference
Dans la commande précédente, j’ai utilisé « -o wide » pour afficher les verbes associés qui peuvent être utilisés pour interagir avec la ressource. Le style général de l’API Kubernetes est RESTful : les clients créent, mettent à jour, suppriment ou récupèrent la description d’un objet via les verbes HTTP standards (POST, PUT, DELETE et GET), et ces API acceptent et retournent du JSON (Kubernetes expose également des endpoints supplémentaires pour des verbes non standards et permet d’autres types de contenu).
Si l’on regarde sous le capot comment fonctionnent les différents composants Kubernetes, on constate qu’ils utilisent tous la même API. Le control plane (API Server, Controllers, Schedulers, etcd, …) est transparent, il n’existe aucune API interne cachée.
Vous pouvez facilement explorer l’API utilisée par la CLI en augmentant la verbosité :
|
et vous pouvez ensuite utiliser la même URI REST que celle affichée dans les logs pour lister les deployments via l’url :
curl http://localhost:8080/apis/extensions/v1beta1/namespaces/default/deployments?limit=500
Astuce : pour accéder à une API Kubernetes distante, vous pouvez utiliser la commande kubectl proxy qui agit comme un reverse proxy (elle gère la localisation du serveur API ainsi que l’authentification), voir https://kubernetes.io/docs/tasks/administer-cluster/access-cluster-api/
Le fait que les composants Kubernetes utilisent tous la même API externe rend Kubernetes composable et extensible.
Kubernetes peut donc gérer une API déclarative et une API impérative.
Dans mon premier exemple, j’ai utilisé l’approche déclarative en créant un fichier yaml et en utilisant la commande kubectl apply.
J’aurais pu, à la place, utiliser l’approche impérative :
|
Je recommande vivement d’utiliser la première approche. Elle permet aux utilisateurs de commit (dans un système de SCM) l’état désiré du cluster, et de garder une trace des différentes versions, ce qui améliore l’auditabilité et l’automatisation via les pipelines CI/CD.
Cela signifie-t-il que l’API impérative est inutile ?
Bien sûr que non ! Il existe plusieurs cas d’usage où l’API impérative a du sens. Par exemple pour interroger l’état des objets, des clusters, … Elle peut être utilisée par des outils de monitoring ou pour du troubleshooting sur certains problèmes… Un autre cas d’usage très pratique consiste à utiliser l’API impérative pour l’approche déclarative, grâce aux options –dry-run et -o yaml :
|
L’utilisation de ces options permet de ne faire qu’afficher l’objet sans l’envoyer.
Vous pouvez choisir le type de ressource à générer via l’option –generator
par exemple pour générer une ressource pod :
|
au lieu d’utiliser l’option –generator, vous pouvez aussi jouer avec l’option –restart (–restart=Never générera un objet pod)
Pour plus d’informations, consultez cette page : https://kubernetes.io/docs/reference/kubectl/conventions/
C’est un moyen très rapide de « bootstrapper » un nouvel objet Kubernetes plutôt que d’écrire un fichier yaml depuis zéro !
Cela m’a énormément aidé lorsque j’ai passé l’examen de certification CKAD.
Conclusion
La gestion de configuration déclarative est l’une des forces majeures de Kubernetes, dans laquelle on définit tout sous forme de desired state.
Cela correspond parfaitement aux exigences du GitOps, qui permet d’utiliser les pull requests Git pour gérer le provisionnement de l’infrastructure et le déploiement des logiciels.
Cela signifie que l’application et l’infrastructure sont désormais toutes deux des artefacts versionnés, faciles à auditer, ce qui est indispensable dans le développement et la livraison logicielle.
Pour aller plus loin, découvrez notre formation Kubernetes et l’accompagnement de nos experts Kubernetes.